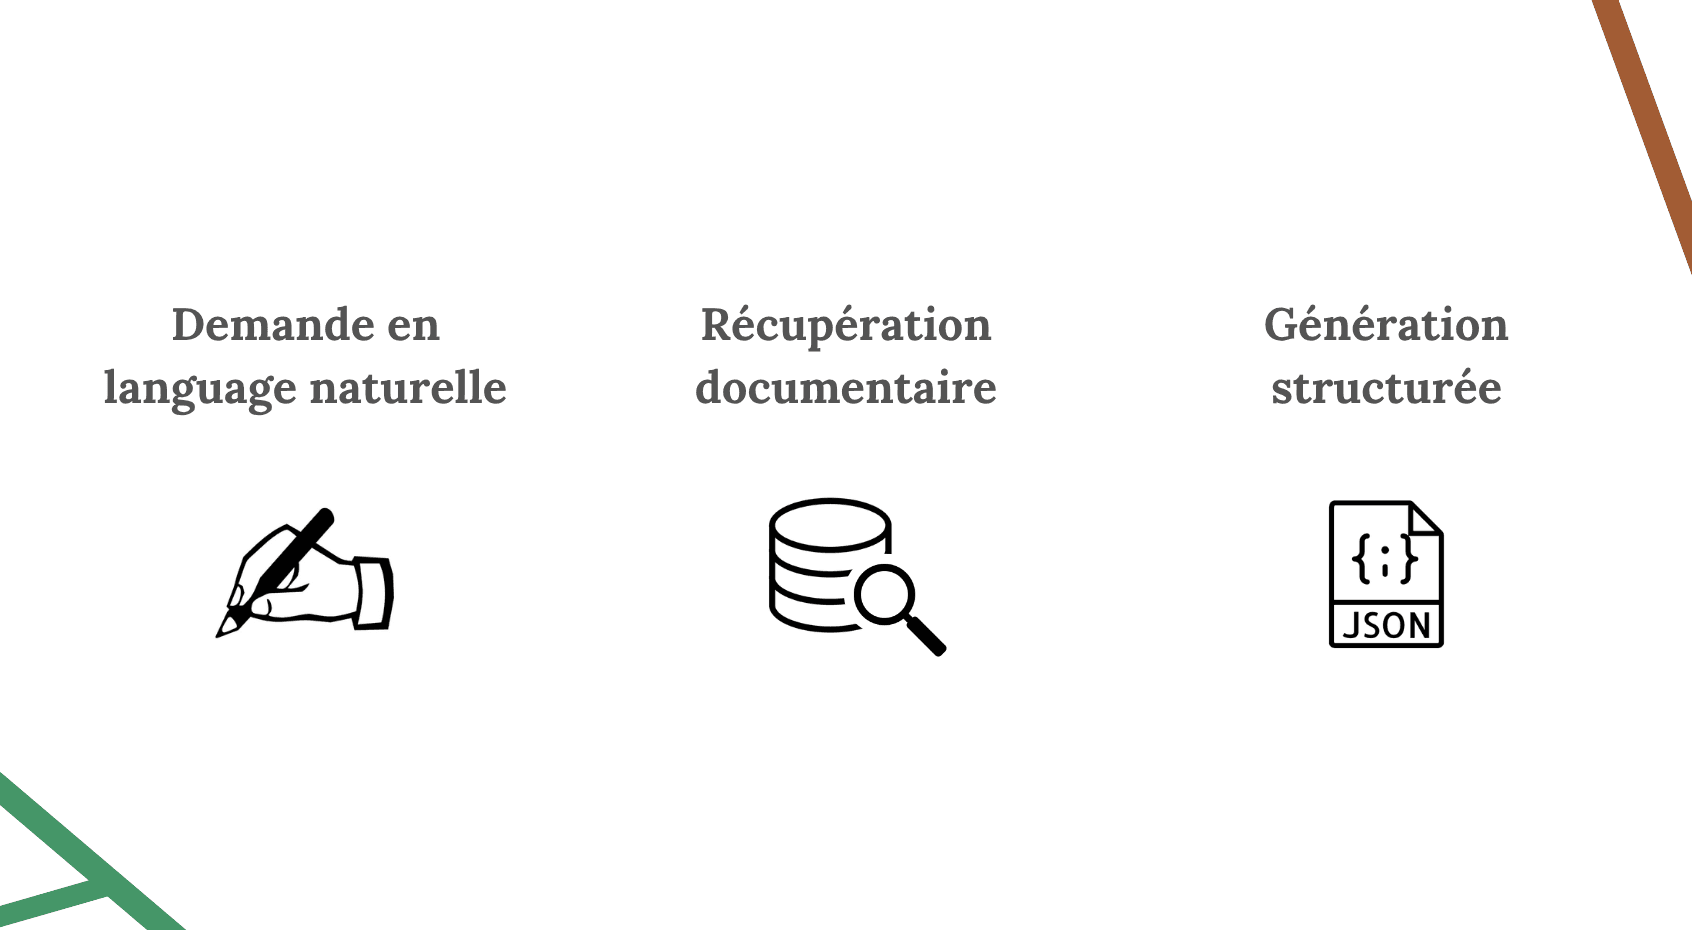
Prototype RAG pour configurations structurées
Prototype RAG traduisant une demande en langage naturel en configuration JSON ou YAML pour un logiciel professionnel.
Problématique métier
Le logiciel concerné permet de créer des configurations techniques détaillées. Cette flexibilité est utile, mais elle rend les usages avancés difficiles pour des utilisateurs peu familiers avec la programmation.
L’enjeu était de faciliter cette création à partir du langage naturel, sans ignorer les contraintes du logiciel.
Mission
Pendant neuf semaines, j’ai conçu et évalué un pipeline allant de la demande utilisateur à une configuration JSON ou YAML validée. J’ai travaillé sur la documentation métier, l’architecture RAG, le jeu d’évaluation et la mise à disposition du prototype par API.
Données & documentation
La documentation existante était destinée à des utilisateurs et se prêtait mal à la recherche sémantique. Je l’ai restructurée en YAML pour mieux représenter les informations et contraintes nécessaires au pipeline.
J’ai aussi commencé à constituer dans Label Studio un jeu de 300 demandes, avec des pré-annotations par LLM. Leur vérification n’était pas terminée à la fin du stage.
Architecture
Une première approche recherchait directement la documentation à partir de la demande complète. Elle confondait parfois des fonctionnalités proches dans leur formulation, mais différentes dans leur comportement.
J’ai donc séparé l’extraction des éléments de la demande, la recherche documentaire et la génération. Pour la recherche, j’ai utilisé une stratégie parent/enfant avec reclassement : de courts exemples permettaient de retrouver puis de sélectionner la documentation associée.
Évaluation
J’ai suivi séparément la recherche documentaire, l’extraction des éléments et la conformité des sorties. Langfuse servait au traçage des exécutions et RAGAS à tester des métriques adaptées au RAG.
Le protocole et le pipeline ont évolué en parallèle, sans jeu indépendant complet pour la dernière version. Je ne présente donc pas les scores intermédiaires comme une mesure de sa performance finale.
J’ai également utilisé t-SNE pour repérer des documents trop proches dans l’espace des embeddings ou rarement récupérés.
Structuration et déploiement du prototype
Le pipeline était exposé avec FastAPI et une interface Streamlit facilitait les essais. L’ensemble était conteneurisé avec Docker Compose.
Pydantic vérifiait la conformité des sorties au format attendu. Cette validation ne garantissait pas leur exactitude métier.
Résultats
Le stage a abouti à un prototype fonctionnel reliant recherche documentaire, génération structurée, validation du format et traçage des exécutions.
Le code, les données, la documentation, les prompts, le schéma des configurations et le rapport de stage ne sont pas publics.
Limites & prochaines étapes
Le prototype traitait une demande puis produisait une réponse. Il ne permettait pas encore d’échanger avec l’utilisateur pour clarifier une demande incomplète, ambiguë ou impossible.
Si je reprenais ce travail, j’ajouterais cette boucle de clarification. Je terminerais aussi l’annotation des 300 demandes et réserverais un jeu indépendant pour comparer les versions du pipeline.