NASA NEO : comparaison de six classifieurs sur un jeu de données déséquilibré
Comparaison de six classifieurs sur 90 836 objets géocroiseurs, avec une analyse centrée sur le déséquilibre des classes et le compromis entre rappel et précision.
- Objets analysés
- 90 836
- Objets classés potentiellement dangereux
- 9,7 %
- Modèles comparés
- 6
- Rappel SVM
- 99,43 %
- Précision SVM
- 29,9 %
Contexte
Projet réalisé à trois dans le cadre du cours IFT712 - Techniques d'apprentissage à l'Université de Sherbrooke. L'objectif était de sélectionner un jeu de données réel puis de comparer six méthodes de classification avec un protocole expérimental commun.
Nous avons retenu le dataset NASA Near-Earth Objects disponible sur Kaggle, qui contient 90 836 objets géocroiseurs, dont seulement 9,7 % sont classés comme potentiellement dangereux.
Problème
Sur un jeu de données aussi déséquilibré, une exactitude (accuracy) élevée peut masquer une mauvaise détection de la classe minoritaire. Nous avons donc choisi le rappel comme métrique prioritaire, tout en analysant la précision, le score F1, l'AUC-ROC et le temps d'exécution.
Approche
Le projet a été structuré en Python autour d'une architecture orientée objet commune aux six modèles, avec une classe abstraite BaseModel pour standardiser l'entraînement, l'évaluation et l'optimisation.
Le pipeline de données comprend :
- sélection de 4 variables pertinentes après exploration du dataset ;
- transformation
log(1+x)des variables fortement asymétriques ; RobustScalerpour limiter l'influence des valeurs extrêmes ;- split stratifié 80/20 ;
class_weight="balanced"pour les modèles linéaires et le SVM ;- optimisation des hyperparamètres avec
GridSearchCVouRandomizedSearchCV.
Les six modèles comparés sont : Decision Tree, SVM, Logistic Regression, Naive Bayes, Neural Network et Least Squares.
Ma contribution
J'ai principalement travaillé sur l'architecture OOP et le pipeline de prétraitement, ainsi que sur l'implémentation de Least Squares et du réseau de neurones.
J'ai également participé à l'optimisation des modèles, à l'analyse comparative des résultats et aux visualisations des performances.
Résultats
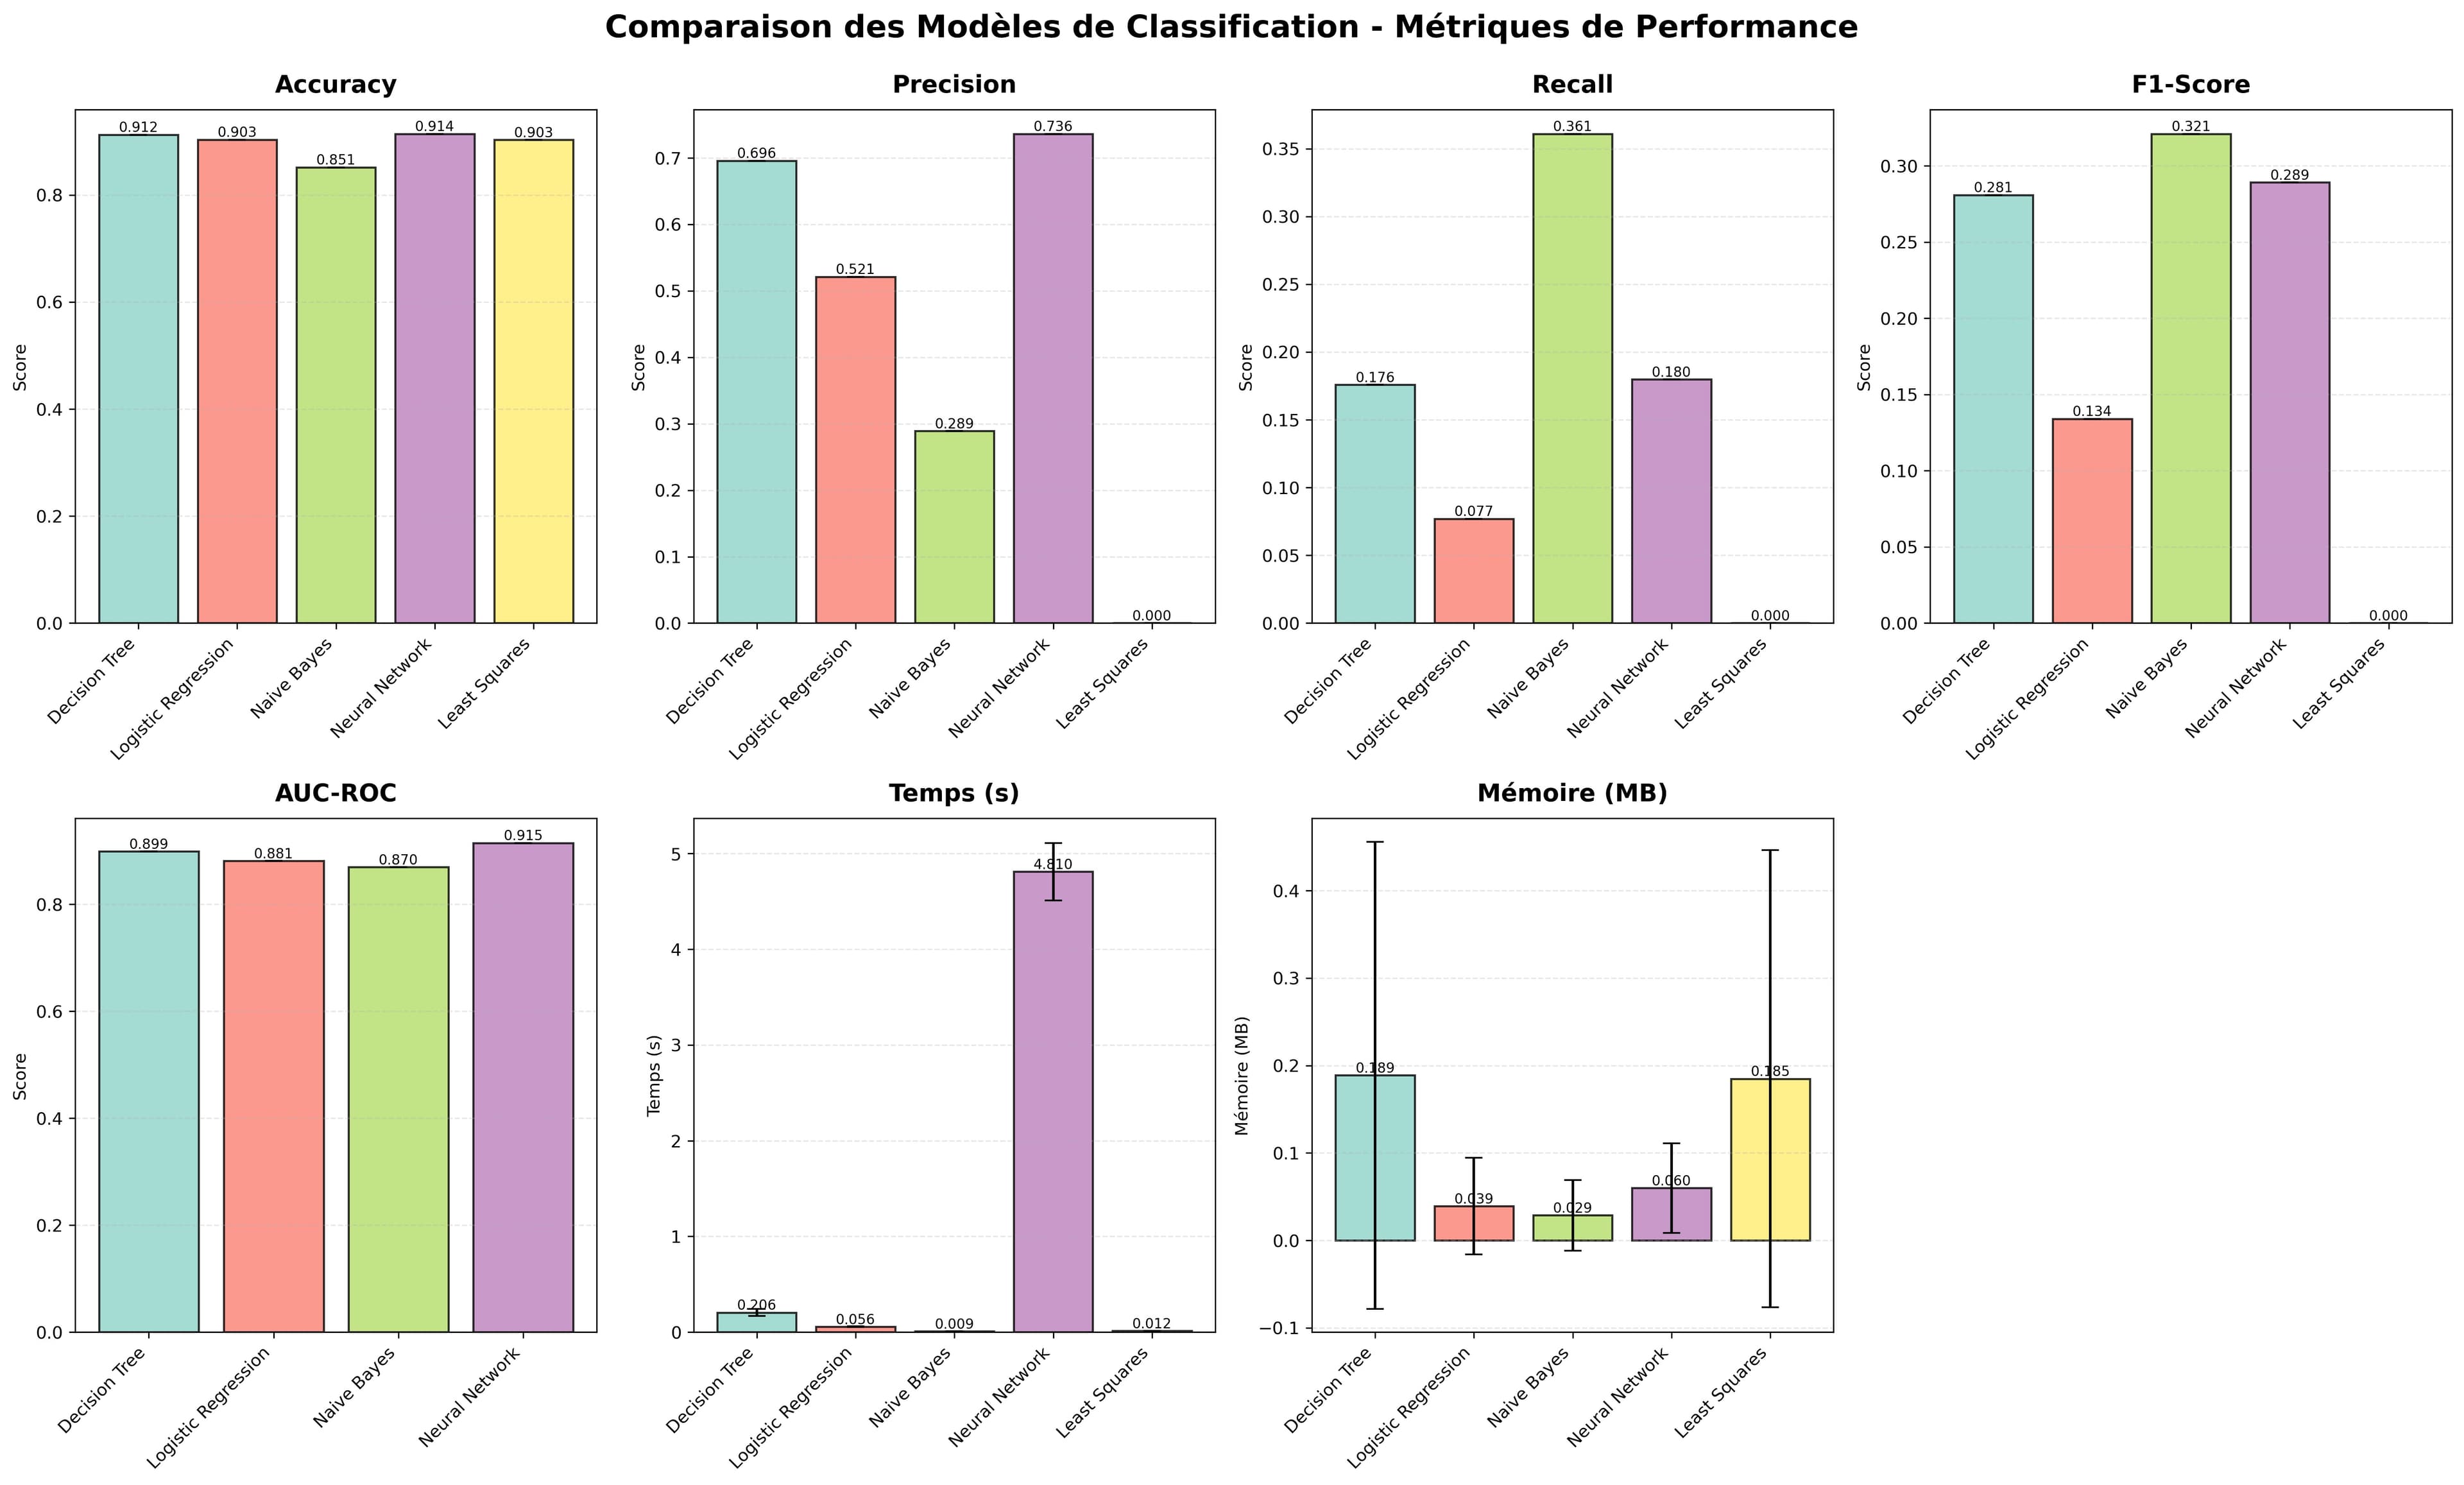
Les résultats montrent un compromis marqué entre détection et précision.
Le SVM obtient le meilleur rappel avec 99,43 %, mais seulement 29,9 % de précision. La méthode des moindres carrés atteint 98,98 % de rappel avec un temps de 0,01 s dans le benchmark rapporté. La régression logistique atteint également 95,02 % de rappel.
À l'inverse, l'arbre de décision et le réseau de neurones obtiennent les meilleures exactitudes, respectivement 91,43 % et 91,45 %, mais avec seulement 13,57 % et 15,10 % de rappel.
L'enseignement principal est que le choix d'un modèle dépend de la métrique et du coût des erreurs considérés, et pas uniquement de son exactitude.
Limites
Cette étude reste une comparaison académique sur un dataset statique. Les résultats ne permettent pas de conclure à une performance opérationnelle sur de nouvelles observations.
Le jeu Kaggle constitue un sous-ensemble des données de la NASA. Le split stratifié 80/20 et la validation croisée utilisée pour régler les hyperparamètres permettent de comparer les modèles dans ce cadre, mais pas de vérifier leur stabilité dans le temps ou sur une autre source de données.
Prochaines étapes
Étudier les seuils de décision permettrait de mieux contrôler le compromis entre Recall et Precision. Une validation temporelle ou sur des données externes permettrait ensuite de vérifier la stabilité des résultats.