Pourquoi j'installais tous mes skills d'agents en global (et comment j'organise mes skills aujourd'hui)
Comment je suis passé de 200 skills en global saturant le contexte de mes agents de codage à un catalogue de 17 skills globaux, des installations locales et une injection temporaire via le presse-papier.
Quand on utilise des agents de codage comme Cursor, Claude Code ou Antigravity, on découvre vite les skills. Ce sont ces dossiers de consignes et de scripts qui apprennent à l'agent à réaliser des tâches précises : traquer un bug difficile, soigner le design d'une interface, résoudre des conflits Git ou analyser des performances.
Au fil de mes découvertes sur GitHub, j'ai installé des dizaines de skills prometteurs. Très vite, je me suis retrouvé avec plus de 200 skills sur ma machine.
Je n'ai pas fait ça pour accumuler des fichiers pour le plaisir, mais par pure facilité. Et pour comprendre comment je me suis retrouvé submergé, il faut regarder comment on gère ses outils au quotidien.
La facilité du « tout en global » (comme pip install sans venv)
En Python, beaucoup de développeurs connaissent ce réflexe : au début, pour aller vite et ne pas s'embêter à créer un environnement virtuel (venv) pour chaque petit script, on installe les packages directement dans son Python global. Tout est disponible immédiatement, partout, sans réfléchir.
Avec les skills, j'ai fait exactement la même chose.
Installer un skill dans un projet précis avec une commande comme npx skills add, c'est très rapide. Le vrai problème n'est pas la commande, c'est la mémoire :
- Pour installer un skill en local dans un nouveau projet, il faut d'abord se rappeler de son nom exact.
- Quand on a des dizaines de skills en tête, on ne sait plus si tel outil s'appelait
anti-ui-slop,ui-reviewoustop-slop. - On passe son temps à rouvrir d'anciens dossiers pour retrouver où on l'avait déjà utilisé et copier la commande.
Pour m'éviter cette gymnastique mentale, j'ai tout installé au global. De cette façon, peu importe le dossier où j'ouvrais mon éditeur ou mon terminal, tous mes skills étaient là, prêts à servir.
Sauf que dans le monde des modèles de langage, le « global » ne fonctionne pas du tout comme une bibliothèque de code classique.
Ce que le « tout en global » implique réellement
Un package Python installé en global dort tranquillement sur le disque. Il ne consomme rien tant qu'on ne l'importe pas dans un fichier.
Pour un assistant IA, c'est différent.
Pour que le modèle sache quels skills existent et puisse décider de les utiliser, l'application injecte en permanence le nom et la description de chaque skill actif dans son prompt système, à chaque échange.
Avec 200 skills en global, cela représentait des milliers de tokens envoyés à chaque requête avant même que je n'écrive le premier mot de mon prompt.
Je ne m'en suis pas rendu compte tout de suite. Le signal est venu directement des interfaces d'agents : des alertes sur les pages de configuration m'indiquaient que la liste des skills devenait trop lourde et saturait le contexte.
Sans que l'agent ne plante, le résultat était visible : le contexte utile était grignoté inutilement, et face à une avalanche de descriptions parfois proches, le modèle finissait par hésiter ou ignorer des skills pourtant pertinents à utiliser.
Pourquoi supprimer ne suffisait pas : le besoin d'une réserve
Mon premier réflexe a été de vouloir faire un grand nettoyage. Mais tout supprimer d'un coup posait un autre souci : parmi ces 200 skills, beaucoup étaient d'excellents outils. J'avais par exemple découvert jupyter-notebook pour manipuler et générer proprement des notebooks Python, ou improve-codebase-architecture pour analyser en profondeur la structure d'un code et proposer des pistes d'amélioration d'architecture.
Ce sont des compétences très utiles, mais qui n'ont rien à faire dans mon prompt quotidien quand je code sur une tâche ordinaire.
Si je les supprimais simplement de ma machine, je perdais la trace de ces outils et de leur nom exact. Il me faut donc :
- Des skills au global : un groupe restreint de skills indispensables pour mes sessions courantes.
- Un catalogue de skills : un endroit isolé sur mon disque pour conserver, documenter et retrouver mes skills spécialisés sans qu'aucun agent ne vienne les charger en mémoire. J'installerais ces skills en local dans un projet.
Aussi, comme j'utilise différents agents de codage (Antigravity, Cursor et Kilo Code) et que leurs répertoires de skills peuvent être différents, il faut donc mettre en place une synchronisation automatique entre ces répertoires.
La pièce manquante : l'usage temporaire via le presse-papier
En observant mes habitudes, j'ai réalisé une chose simple : la plupart des skills pointus n'ont même pas besoin d'être installés dans un projet.
Si je veux lancer une passe ponctuelle d'audit d'architecture avec improve-codebase-architecture ou traiter un notebook Jupyter un après-midi, c'est une action temporaire. Pourquoi installer ce skill dans mon projet (au risque d'ajouter des fichiers inutiles au dépôt Git) ou l'ajouter en global (où il alourdirait chaque prompt pour rien) ?
Pour automatiser cette injection sans dépendre d'un outil externe lourd, je me suis écrit un petit script CLI local. Avec la commande manage-skills use <nom-du-skill>, le script va chercher les consignes complètes du skill dans ma réserve locale (~/.agents/catalog/) et les place directement dans mon presse-papier Windows. Il me suffit de faire Ctrl + V dans la discussion active avec l'agent. Actuellement, la commande ne fonctionne que pour les skills composés d'un seul fichier.
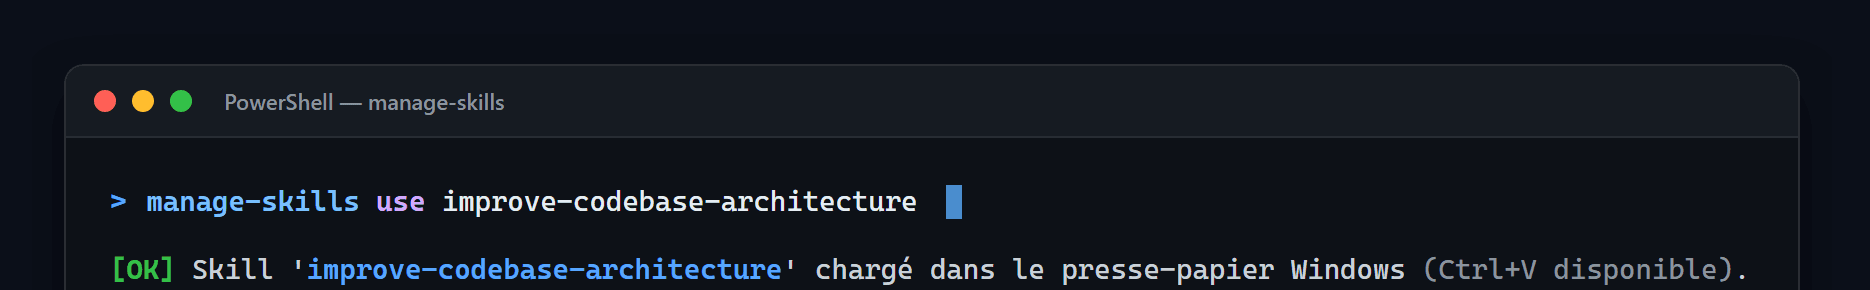
L'agent lit les consignes pour la tâche demandée et fait son travail sans se rajouter dans le system prompt (local ou global).
Mon organisation actuelle : du global au local, jusqu'au presse-papier
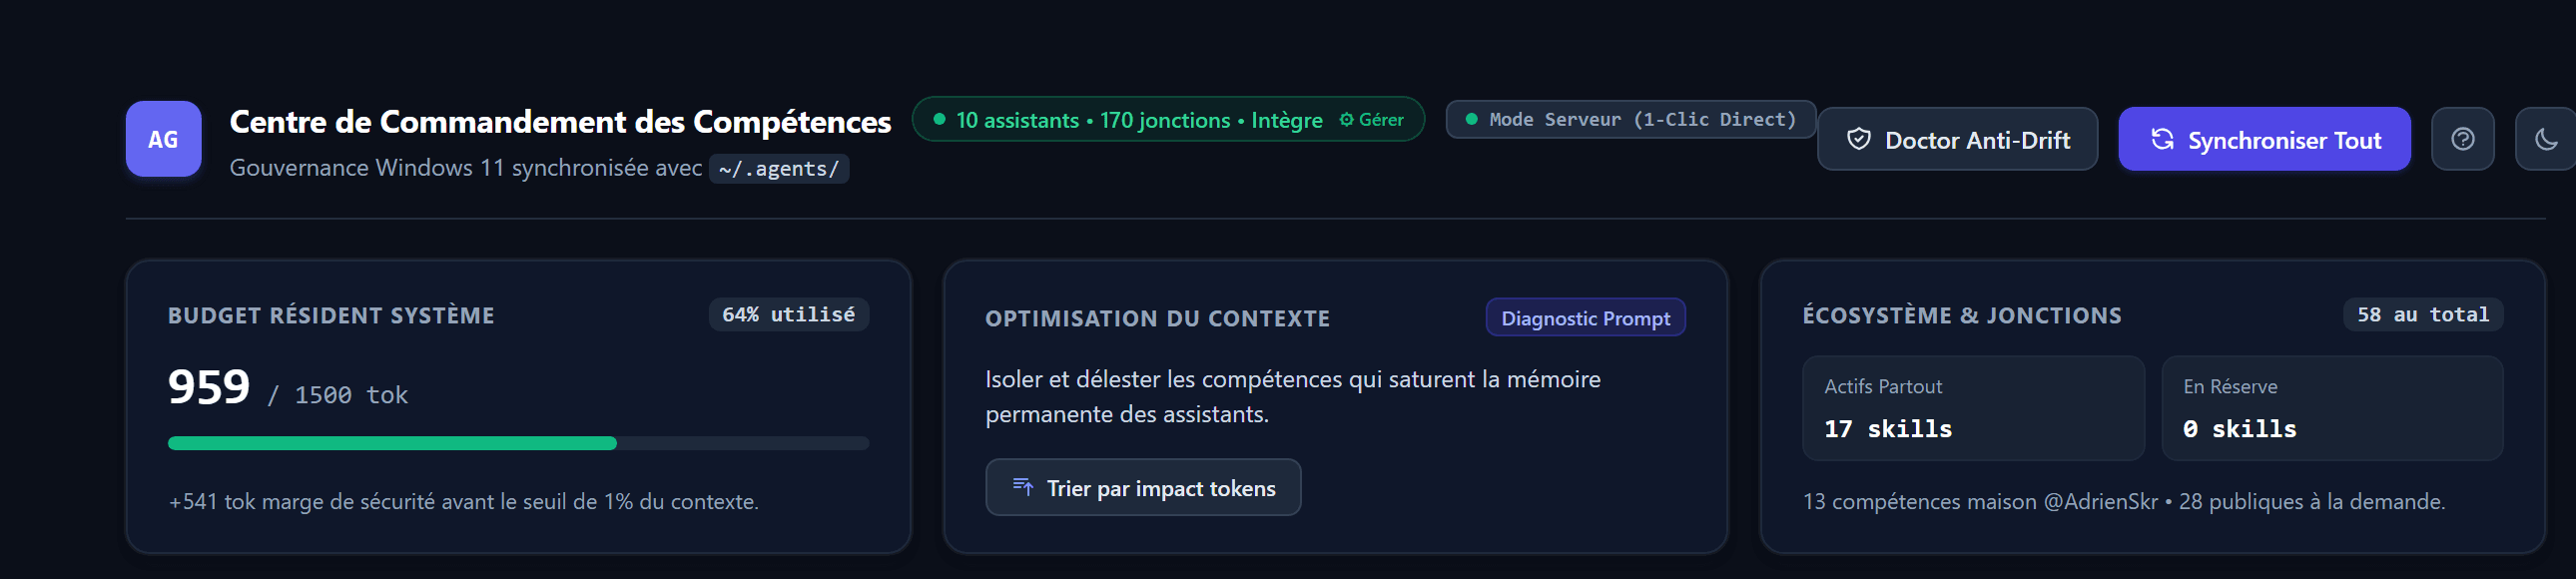
Aujourd'hui, mes outils s'organisent autour d'un catalogue de skills :
Bibliothèque / Réserve
~/.agents/catalog/
Stockage passif sur disque — 0 token consommé par les assistants
Skills du quotidien
~/.agents/skills/
Projet local
npx skills add
Presse-papier
manage-skills use
- Skills du quotidien (installation globale, 17 actifs) : Les outils transversaux indispensables (
code-review,diagnosing-bugs...), regroupés dans~/.agents/skills/et partagés entre mes 10 assistants via des jonctions NTFS (mklink /J), sous un plafond de 1 500 tokens. - Projet local (installation locale, dossier ciblé) : Les compétences spécialisées pour une stack précise (
jupyter-notebook), installées directement dans le dossier du projet vianpx skills add. - Presse-papier (usage ponctuel,
Ctrl + V) : Les outils d'audit ou d'analyse isolés (improve-codebase-architecture), injectés à la volée avec la commandemanage-skills usesans alourdir le prompt ni laisser de trace sur le disque. - Catalogue de skills (
~/.agents/catalog/) : Le répertoire sur disque où sont stockés tous les autres skills découverts au fil de mes recherches et de ma veille, sans être chargés dans la mémoire des assistants.
Ce qui a changé en pratique
Le résultat le plus marquant n'est pas seulement d'avoir fait disparaître les alertes de configuration.
C'est le comportement de mes assistants : avec 17 skills bien ciblés au lieu de 200, les agents se sont mis à utiliser leurs outils spontanément.
Quand le prompt était noyé sous des dizaines de descriptions, le modèle ne savait plus quoi choisir et je devais souvent lui dicter quel skill appeler. Avec un catalogue court et clair, l'agent comprend tout de suite quand dégainer diagnosing-bugs ou code-review, sans que j'aie besoin de lui demander.
Installer tout en global est un réflexe tentant pour s'éviter des frictions de mémoire. Mais une fois qu'on mesure l'impact des descriptions sur le contexte de l'IA, faire le tri change tout : garder ses quelques outils quotidiens en global, installer les compétences spécialisées uniquement dans les projets qui en ont besoin, et passer par le presse-papier pour les besoins ponctuels.